GLM-5.3 : Z.ai améliore son modèle IA et prend la tête de l’ED-O-Meter
Z.ai dévoile GLM-5.3, une évolution axée sur le code et la cybersécurité qui prend la tête du classement ED-O-Meter.
Deux mois après GLM-5.2, Z.ai présente déjà GLM-5.3, une nouvelle version de son grand modèle d’intelligence artificielle consacré au développement, aux agents autonomes et aux tâches longues.
Il ne s’agit toutefois pas d’un nouveau modèle entraîné depuis zéro. GLM-5.3 conserve la même base que GLM-5.2. Les améliorations annoncées viennent principalement d’un post-entraînement plus poussé, réalisé avec davantage d’environnements, de tâches et de calcul.
Pour retrouver les caractéristiques de l’architecture, vous pouvez consulter mon précédent article consacré à GLM-5.2 et sa fenêtre d’un million de tokens.
Sa fenêtre de contexte peut toujours atteindre un million de tokens. Le modèle est donc capable, en théorie, de travailler sur de gros dépôts de code, de longues documentations ou des sessions agentiques composées de nombreuses étapes.
Cette architecture reste extrêmement lourde à héberger. Le fait que seulement 40 milliards de paramètres soient activés simultanément ne signifie pas que le modèle peut être chargé comme un LLM classique de 40 milliards de paramètres. L’ensemble des experts doit rester accessible pendant l’inférence.
La principale nouveauté se trouve donc dans le post-entraînement. Z.ai explique avoir multiplié les environnements proches de situations professionnelles réelles : recherche de problèmes dans une infrastructure, optimisation des performances, modification de logiciels ou exécution de tâches nécessitant plusieurs heures de travail.
En mode Max, GLM-5.3 atteint un taux de réussite de 34,5 %, contre 23,4 % pour GLM-5.2. Il consommerait également moins de tokens, avec environ 75 000 tokens de sortie par tâche contre 96 000 pour son prédécesseur.
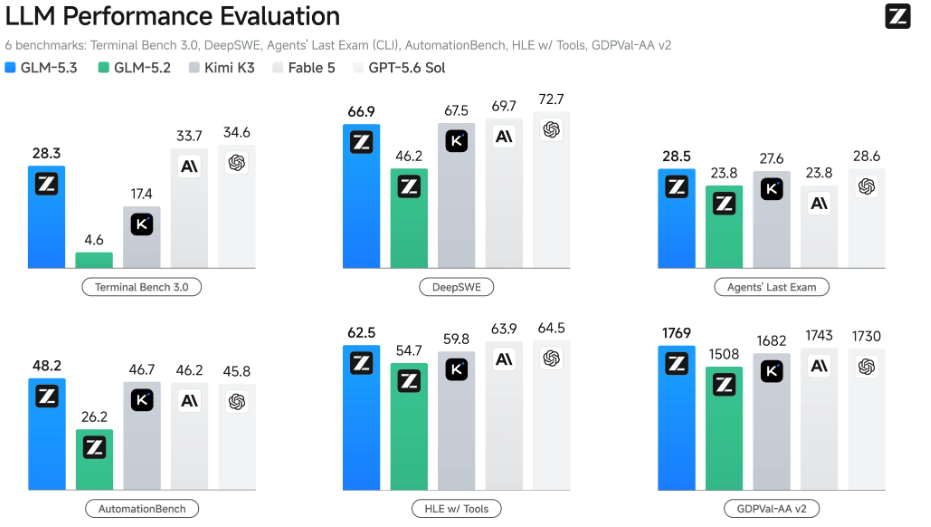
Ces résultats proviennent principalement des évaluations publiées par Z.ai. Ils utilisent des configurations spécifiques, parfois avec une fenêtre de contexte très longue, plusieurs tentatives et des limites pouvant atteindre plusieurs heures par tâche.
Ils montrent une progression intéressante, mais ne suffisent pas à affirmer que GLM-5.3 sera meilleur dans tous les environnements de développement.
Contrairement à GLM-5.2, il n’est plus possible de désactiver complètement le raisonnement. Une application qui utilisait auparavant le paramètre « thinking.type: disabled » devra donc être adaptée avant de passer au nouveau modèle.
Le mode Low peut être utilisé pour limiter la consommation et réduire le temps de réponse. Les modes High et Max autorisent des raisonnements plus longs, mais peuvent produire plusieurs dizaines de milliers de tokens sur une tâche agentique complexe.
Sur CyberGym, GLM-5.3 obtient un score annoncé de 84,5 %, contre 77,2 % pour GLM-5.2. Ce benchmark demande au modèle d’analyser du code source, d’identifier une vulnérabilité et de confirmer son existence en provoquant une erreur.
Le progrès est encore plus important sur les tâches d’exploitation. GLM-5.3 atteint 54,4 % sur ExploitBench, contre 24,4 % pour GLM-5.2.
Sur ExploitGym, il termine 105 tâches avec une limite normalisée de deux heures et 130 tâches avec six heures, contre respectivement 29 et 39 pour GLM-5.2.
Les modèles fermés les plus avancés restent cependant devant sur les tests d’exploitation. Fable 5 et GPT-5.6 Sol obtiennent notamment des résultats nettement supérieurs sur ExploitBench et ExploitGym.
Z.ai affirme par ailleurs avoir utilisé ses modèles pour analyser 269 projets open source. Après vérification et suppression des doublons, 2 436 vulnérabilités auraient été recensées, dont 1 097 classées critiques ou importantes.
La majorité de ces découvertes est encore soumise à un processus de divulgation coordonnée. Ces chiffres doivent donc être considérés comme des affirmations de Z.ai tant que les problèmes concernés ne sont pas publiquement documentés.
L’entreprise a choisi de repousser leur mise en ligne pendant environ deux semaines afin de poursuivre ses évaluations de sécurité et le renforcement du modèle. La publication devrait donc intervenir autour du 28 août, si ce calendrier est respecté.
En attendant, GLM-5.3 est principalement utilisable à travers les services et l’API de Z.ai. Il faudra attendre la publication effective des fichiers et de leur licence pour confirmer les possibilités d’auto-hébergement.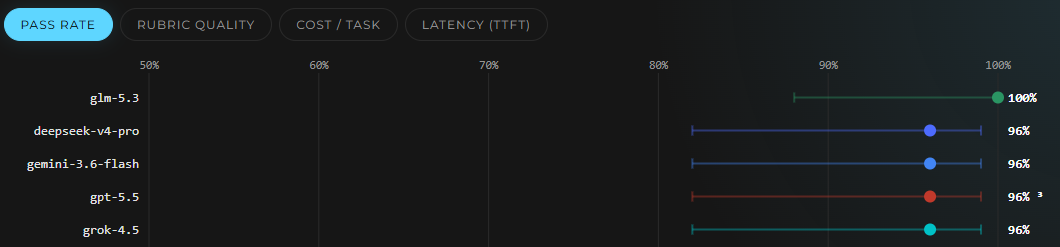
Une seconde évaluation intéressante vient de l’ED-O-Meter, un classement publié par Reinvently et indépendant de Z.ai.
Dans sa mise à jour du 23 août 2026, le test compare 17 modèles sur 28 tâches identiques. Les requêtes sont envoyées par la même infrastructure à travers OpenRouter, avec les mêmes prompts et des corrections automatisées.
Les tâches couvrent cinq catégories :
- sept exercices de programmation en Python ;
- quatre tâches liées aux données ;
- neuf situations courantes ;
- six tests de sécurité et de résistance aux injections ;
- deux tests d’utilisation d’outils.
GLM-5.3 est le premier modèle testé à obtenir un taux de réussite de 100 % dans les cinq catégories. Il reçoit également une note de qualité de 9,3 sur 10.
Le coût total observé pour les 28 tâches atteint 0,28 dollar. Son principal défaut reste son temps de réponse, avec une médiane de 16,3 secondes avant l’apparition du premier token.
À titre de comparaison, Kimi K3 conserve la meilleure note de qualité avec 9,5 sur 10 et un taux de réussite de 96 %, mais demande 26,4 secondes avant le premier token. Haiku 4.5 atteint également 96 % tout en répondant beaucoup plus rapidement, avec seulement 0,9 seconde avant le premier token.
Il ne s’agit toutefois pas d’un classement définitif des meilleures intelligences artificielles.
Chaque modèle n’a effectué qu’un seul passage sur 28 tâches. L’échantillon reste donc limité et la marge d’incertitude est importante. La note de qualité est aussi attribuée par un autre modèle, Fable 5, ce qui peut introduire un biais.
Les mécanismes de sécurité des fournisseurs influencent également le classement. Certains modèles Claude ont par exemple refusé des exercices de débogage pourtant présentés comme légitimes. Ces refus sont comptabilisés comme des échecs, même s’ils proviennent d’un filtre placé devant le modèle.
Enfin, les coûts et les temps de réponse mesurés à travers OpenRouter ne représentent pas nécessairement les performances obtenues avec une autre API ou un déploiement local.
Ce classement reste malgré tout un signal intéressant. GLM-5.3 ne progresse pas uniquement dans les tableaux publiés par son créateur : il obtient aussi de bons résultats sur un petit ensemble de tâches pratiques exécutées par un tiers.
La vraie vérification arrivera après la publication de ses poids. La communauté pourra alors mesurer ses performances, sa consommation de mémoire, sa stabilité et sa capacité à travailler longtemps sur de vrais projets.
L’annonce complète est disponible sur le blog de Z.ai. Le classement et le détail des 28 tâches peuvent être consultés sur l’ED-O-Meter de Reinvently.
← Retour aux posts
Il ne s’agit toutefois pas d’un nouveau modèle entraîné depuis zéro. GLM-5.3 conserve la même base que GLM-5.2. Les améliorations annoncées viennent principalement d’un post-entraînement plus poussé, réalisé avec davantage d’environnements, de tâches et de calcul.
Pour retrouver les caractéristiques de l’architecture, vous pouvez consulter mon précédent article consacré à GLM-5.2 et sa fenêtre d’un million de tokens.
Le même modèle de base que GLM-5.2
GLM-5.3 conserve l’architecture Mixture of Experts de GLM-5.2. Celle-ci rassemble 753 milliards de paramètres au total, dont environ 40 milliards sont activés pour chaque token traité.Sa fenêtre de contexte peut toujours atteindre un million de tokens. Le modèle est donc capable, en théorie, de travailler sur de gros dépôts de code, de longues documentations ou des sessions agentiques composées de nombreuses étapes.
Cette architecture reste extrêmement lourde à héberger. Le fait que seulement 40 milliards de paramètres soient activés simultanément ne signifie pas que le modèle peut être chargé comme un LLM classique de 40 milliards de paramètres. L’ensemble des experts doit rester accessible pendant l’inférence.
La principale nouveauté se trouve donc dans le post-entraînement. Z.ai explique avoir multiplié les environnements proches de situations professionnelles réelles : recherche de problèmes dans une infrastructure, optimisation des performances, modification de logiciels ou exécution de tâches nécessitant plusieurs heures de travail.
Des progrès annoncés dans le développement
Sur son propre benchmark interne, Z.ai Code Bench, l’entreprise annonce une amélioration de 50 % par rapport à GLM-5.2.En mode Max, GLM-5.3 atteint un taux de réussite de 34,5 %, contre 23,4 % pour GLM-5.2. Il consommerait également moins de tokens, avec environ 75 000 tokens de sortie par tâche contre 96 000 pour son prédécesseur.
Ces résultats proviennent principalement des évaluations publiées par Z.ai. Ils utilisent des configurations spécifiques, parfois avec une fenêtre de contexte très longue, plusieurs tentatives et des limites pouvant atteindre plusieurs heures par tâche.
Ils montrent une progression intéressante, mais ne suffisent pas à affirmer que GLM-5.3 sera meilleur dans tous les environnements de développement.
Trois niveaux de raisonnement
GLM-5.3 propose trois niveaux d’effort de raisonnement : Low, High et Max. Le mode Max est activé par défaut et recommandé par Z.ai pour les tâches de programmation complexes.Contrairement à GLM-5.2, il n’est plus possible de désactiver complètement le raisonnement. Une application qui utilisait auparavant le paramètre « thinking.type: disabled » devra donc être adaptée avant de passer au nouveau modèle.
Le mode Low peut être utilisé pour limiter la consommation et réduire le temps de réponse. Les modes High et Max autorisent des raisonnements plus longs, mais peuvent produire plusieurs dizaines de milliers de tokens sur une tâche agentique complexe.
Des capacités de cybersécurité inattendues
Z.ai a également intégré au post-entraînement des environnements consacrés à la recherche de vulnérabilités. D’après l’entreprise, les capacités obtenues auraient progressé plus rapidement que prévu.Sur CyberGym, GLM-5.3 obtient un score annoncé de 84,5 %, contre 77,2 % pour GLM-5.2. Ce benchmark demande au modèle d’analyser du code source, d’identifier une vulnérabilité et de confirmer son existence en provoquant une erreur.
Le progrès est encore plus important sur les tâches d’exploitation. GLM-5.3 atteint 54,4 % sur ExploitBench, contre 24,4 % pour GLM-5.2.
Sur ExploitGym, il termine 105 tâches avec une limite normalisée de deux heures et 130 tâches avec six heures, contre respectivement 29 et 39 pour GLM-5.2.
Les modèles fermés les plus avancés restent cependant devant sur les tests d’exploitation. Fable 5 et GPT-5.6 Sol obtiennent notamment des résultats nettement supérieurs sur ExploitBench et ExploitGym.
Z.ai affirme par ailleurs avoir utilisé ses modèles pour analyser 269 projets open source. Après vérification et suppression des doublons, 2 436 vulnérabilités auraient été recensées, dont 1 097 classées critiques ou importantes.
La majorité de ces découvertes est encore soumise à un processus de divulgation coordonnée. Ces chiffres doivent donc être considérés comme des affirmations de Z.ai tant que les problèmes concernés ne sont pas publiquement documentés.
Les poids ne sont pas encore disponibles
Z.ai présente GLM-5.3 comme un futur modèle open weights, mais ses poids n’étaient pas encore publiés au 24 août 2026.L’entreprise a choisi de repousser leur mise en ligne pendant environ deux semaines afin de poursuivre ses évaluations de sécurité et le renforcement du modèle. La publication devrait donc intervenir autour du 28 août, si ce calendrier est respecté.
En attendant, GLM-5.3 est principalement utilisable à travers les services et l’API de Z.ai. Il faudra attendre la publication effective des fichiers et de leur licence pour confirmer les possibilités d’auto-hébergement.
GLM-5.3 ne doit pas encore être présenté comme un modèle que l’on peut télécharger et installer localement. Z.ai promet des poids ouverts, mais ceux-ci ne sont pas disponibles au moment de cette news.
GLM-5.3 prend la tête de l’ED-O-Meter
Une seconde évaluation intéressante vient de l’ED-O-Meter, un classement publié par Reinvently et indépendant de Z.ai.
Dans sa mise à jour du 23 août 2026, le test compare 17 modèles sur 28 tâches identiques. Les requêtes sont envoyées par la même infrastructure à travers OpenRouter, avec les mêmes prompts et des corrections automatisées.
Les tâches couvrent cinq catégories :
- sept exercices de programmation en Python ;
- quatre tâches liées aux données ;
- neuf situations courantes ;
- six tests de sécurité et de résistance aux injections ;
- deux tests d’utilisation d’outils.
GLM-5.3 est le premier modèle testé à obtenir un taux de réussite de 100 % dans les cinq catégories. Il reçoit également une note de qualité de 9,3 sur 10.
Le coût total observé pour les 28 tâches atteint 0,28 dollar. Son principal défaut reste son temps de réponse, avec une médiane de 16,3 secondes avant l’apparition du premier token.
À titre de comparaison, Kimi K3 conserve la meilleure note de qualité avec 9,5 sur 10 et un taux de réussite de 96 %, mais demande 26,4 secondes avant le premier token. Haiku 4.5 atteint également 96 % tout en répondant beaucoup plus rapidement, avec seulement 0,9 seconde avant le premier token.
Un classement intéressant, mais encore limité
L’ED-O-Meter a le mérite d’utiliser les mêmes tâches et les mêmes prompts pour chaque modèle. Son environnement de test, appelé Featherbench, est également publié en open source afin de permettre la reproduction des résultats.Il ne s’agit toutefois pas d’un classement définitif des meilleures intelligences artificielles.
Chaque modèle n’a effectué qu’un seul passage sur 28 tâches. L’échantillon reste donc limité et la marge d’incertitude est importante. La note de qualité est aussi attribuée par un autre modèle, Fable 5, ce qui peut introduire un biais.
Les mécanismes de sécurité des fournisseurs influencent également le classement. Certains modèles Claude ont par exemple refusé des exercices de débogage pourtant présentés comme légitimes. Ces refus sont comptabilisés comme des échecs, même s’ils proviennent d’un filtre placé devant le modèle.
Enfin, les coûts et les temps de réponse mesurés à travers OpenRouter ne représentent pas nécessairement les performances obtenues avec une autre API ou un déploiement local.
Ce classement reste malgré tout un signal intéressant. GLM-5.3 ne progresse pas uniquement dans les tableaux publiés par son créateur : il obtient aussi de bons résultats sur un petit ensemble de tâches pratiques exécutées par un tiers.
La vraie vérification arrivera après la publication de ses poids. La communauté pourra alors mesurer ses performances, sa consommation de mémoire, sa stabilité et sa capacité à travailler longtemps sur de vrais projets.
L’annonce complète est disponible sur le blog de Z.ai. Le classement et le détail des 28 tâches peuvent être consultés sur l’ED-O-Meter de Reinvently.