GLM-5.2 : Z.ai dévoile une IA open weights avec un contexte d’un million de tokens
Z.ai lance GLM-5.2, un modèle IA aux poids ouverts sous licence MIT, conçu pour le code agentique avec un contexte d’un million de tokens.
Z.ai vient de publier GLM-5.2, un nouveau modèle d’intelligence artificielle principalement pensé pour le développement, les agents autonomes et les tâches longues.
Dévoilé le 16 juin 2026, GLM-5.2 succède à GLM-5.1 avec une évolution importante : sa fenêtre de contexte peut atteindre un million de tokens. Le modèle est donc capable, en théorie, de traiter de très gros dépôts de code, de longues documentations ou des sessions agentiques composées de nombreuses étapes.Mais une grande fenêtre de contexte ne garantit pas automatiquement que le modèle utilisera correctement toutes les informations fournies. Z.ai affirme justement avoir renforcé son entraînement sur des scénarios longs, comme la création de logiciels, la recherche automatisée, l’optimisation des performances et le débogage complexe.
Un modèle massif basé sur une architecture MoE
GLM-5.2 utilise une architecture Mixture of Experts, ou MoE. Il possède 753 milliards de paramètres au total, mais seulement 40 milliards sont activés pour chaque token traité.Cette approche permet de limiter une partie du coût de calcul sans réduire la capacité globale du modèle. Cela ne veut toutefois pas dire que GLM-5.2 peut être exécuté comme un simple modèle de 40 milliards de paramètres : l’ensemble des experts doit rester accessible durant l’inférence.
La version complète reste donc très lourde. En BF16, les poids bruts représentent théoriquement autour de 1,5 To, avant même de compter le cache KV et les autres besoins en mémoire. Les versions quantifiées pourront réduire cette empreinte, mais un déploiement local complet demandera toujours une infrastructure sérieuse.
Le modèle prend notamment en charge :
- une fenêtre de contexte allant jusqu’à un million de tokens ;
- plusieurs niveaux d’effort de raisonnement ;
- les modes High et Max ;
- le déploiement avec Transformers, vLLM, SGLang et KTransformers ;
- une utilisation avec des agents de développement comme Claude Code ou OpenCode.
Le mode High cherche un équilibre entre performances, consommation de tokens et temps de réponse. Le mode Max autorise davantage de calcul pour les problèmes complexes.
Des résultats intéressants pour le développement
D’après les tests publiés par Z.ai, GLM-5.2 obtient un score de 81,0 sur Terminal-Bench 2.1, contre 63,5 pour GLM-5.1. Il atteint également 62,1 sur SWE-bench Pro et 74,4 sur FrontierSWE.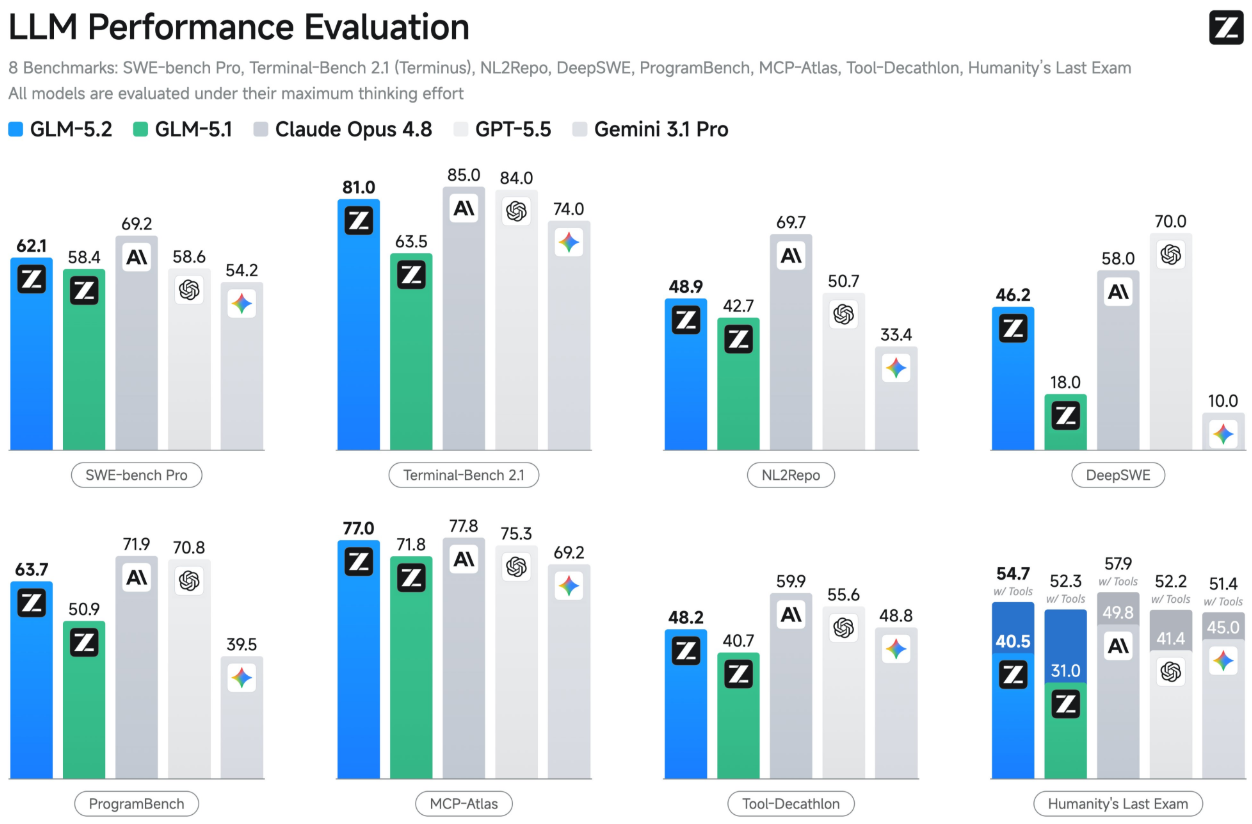
Ces résultats sont encourageants, mais certains ont été obtenus avec des configurations, des agents et des limites de contexte spécifiques. Comparer deux modèles uniquement à partir d’un tableau fourni par leur créateur reste donc assez délicat.
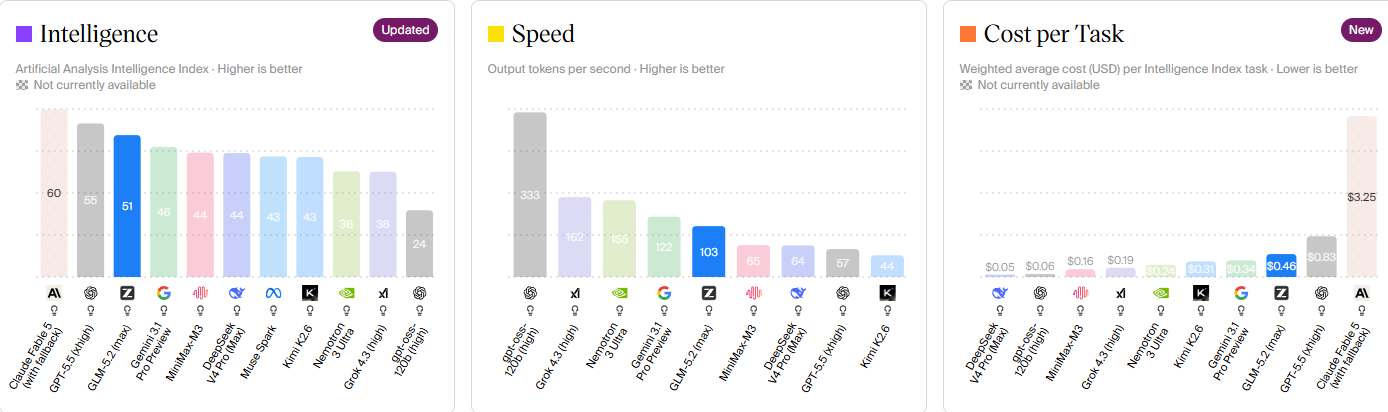
Artificial Analysis propose une mesure plus indépendante de la variante GLM-5.2 Max. Au moment de son évaluation, le modèle obtient un score de 51 sur son Intelligence Index, ce qui le place en première position parmi les 92 modèles de sa catégorie.
La plateforme mesure également une vitesse médiane d’environ 103 tokens par seconde et un délai de 2,18 secondes avant le premier token. Elle remarque cependant que GLM-5.2 est assez bavard et plus cher que beaucoup d’autres modèles aux poids ouverts de taille comparable.
Les tarifs médians observés chez les fournisseurs sont de 1,40 dollar par million de tokens en entrée et de 4,40 dollars en sortie. Les prix peuvent naturellement varier selon la plateforme utilisée.
Open source ou simplement open weights ?
Les poids de GLM-5.2 sont disponibles sur Hugging Face sous licence MIT. Cette licence permet notamment son utilisation commerciale, sa modification et son auto-hébergement.Il est malgré tout plus précis de parler de modèle open weights. Z.ai ne publie pas nécessairement l’intégralité des données d’entraînement, des mécanismes de filtrage et du pipeline ayant permis de produire le modèle.
La disponibilité des poids ne signifie pas que le modèle pourra être facilement exécuté sur un PC classique. Avec 753 milliards de paramètres, GLM-5.2 vise surtout les serveurs équipés de plusieurs accélérateurs.
GLM-5.2 reste une sortie intéressante, particulièrement pour les agents de développement capables de travailler plusieurs heures sur un projet. Sa fenêtre d’un million de tokens et ses performances indépendantes le placent parmi les modèles ouverts les plus ambitieux du moment.Il faudra maintenant observer son comportement dans de vrais projets : consommation de tokens, stabilité sur les longues sessions, qualité des modifications et capacité à ne pas se perdre dans un gros dépôt. Les benchmarks donnent une direction, mais ils ne remplacent toujours pas une bonne vieille utilisation sur du code réel.
Sources :
Annonce officielle de Z.ai
GLM-5.2 sur Hugging Face
Évaluation d’Artificial Analysis
Article de LeBigData