MarkItDown : convertir PDF, Word et Excel en Markdown
Découverte de MarkItDown, l’outil open source de Microsoft pour convertir des fichiers PDF, Word, Excel et autres formats en Markdown.
MarkItDown : convertir PDF, Word et Excel en Markdown
Un outil open source de Microsoft pour transformer rapidement des documents en Markdown, notamment avant de les transmettre à une IA.
Je suis tombé sur MarkItDown, un petit outil Python développé par Microsoft pour convertir différents types de fichiers en Markdown.Le principe est simple : on lui donne un PDF, un document Word, un fichier Excel ou une présentation PowerPoint, et il génère un fichier texte structuré en Markdown.
Ce n’est pas un convertisseur destiné à reproduire parfaitement la mise en page d’origine. Son objectif est plutôt de récupérer le contenu utile : titres, listes, tableaux, liens et texte.
C’est particulièrement intéressant pour préparer des documents destinés à un LLM, un moteur de recherche, une base documentaire ou simplement pour récupérer proprement le contenu d’un fichier.
Dépôt officiel Microsoft MarkItDown
Quels formats sont pris en charge ?
MarkItDown sait convertir pas mal de formats :
PDF
Word
PowerPoint
Excel
HTML
CSV
JSON
XML
Images
Audio
ZIP
EPUB
URL YouTube
Le support exact dépend des extensions Python installées.Word
PowerPoint
Excel
HTML
CSV
JSON
XML
Images
Audio
ZIP
EPUB
URL YouTube
Pour les images, MarkItDown peut récupérer les métadonnées EXIF et utiliser de l’OCR. Pour l’audio, il peut extraire les métadonnées et produire une transcription.
MarkItDown ne cherche pas à refaire un document Word ou PDF à l’identique. Le résultat est pensé pour l’analyse de texte et les outils IA, pas pour conserver une mise en page complexe au pixel près.
Installer MarkItDown
MarkItDown demande Python 3.10 ou une version plus récente.Je conseille de créer un environnement virtuel pour éviter de mélanger ses dépendances avec les autres outils Python installés sur la machine.
Sous Windows :
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install --upgrade pip
pip install 'markitdown[all]'
Sous Linux :
.\.venv\Scripts\Activate.ps1
python -m pip install --upgrade pip
pip install 'markitdown[all]'
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install 'markitdown[all]'
L’option `all` installe les dépendances nécessaires pour tous les formats pris en charge.source .venv/bin/activate
python -m pip install --upgrade pip
pip install 'markitdown[all]'
Si on veut seulement travailler avec des PDF, documents Word et fichiers Excel, on peut limiter l’installation :
pip install 'markitdown[pdf,docx,xlsx]'
● Python 3.10 ou plus récent
● pip
● Un terminal PowerShell, Windows Terminal ou Linux
● pip
● Un terminal PowerShell, Windows Terminal ou Linux
Convertir un PDF en Markdown
La commande de base est très simple.
markitdown document.pdf -o document.md
MarkItDown lit le fichier `document.pdf`, puis écrit le résultat dans `document.md`.Sans l’option de sortie, le contenu est directement affiché dans le terminal :
markitdown document.pdf
Une fois la conversion terminée, on peut ouvrir le fichier Markdown dans Visual Studio Code ou n’importe quel éditeur de texte.Le résultat dépend évidemment du PDF utilisé. Un document contenant du vrai texte sera généralement plus simple à convertir qu’un ancien scan composé uniquement d’images.
Convertir un document Word
La même commande fonctionne avec un document Word :
markitdown document.docx -o document.md
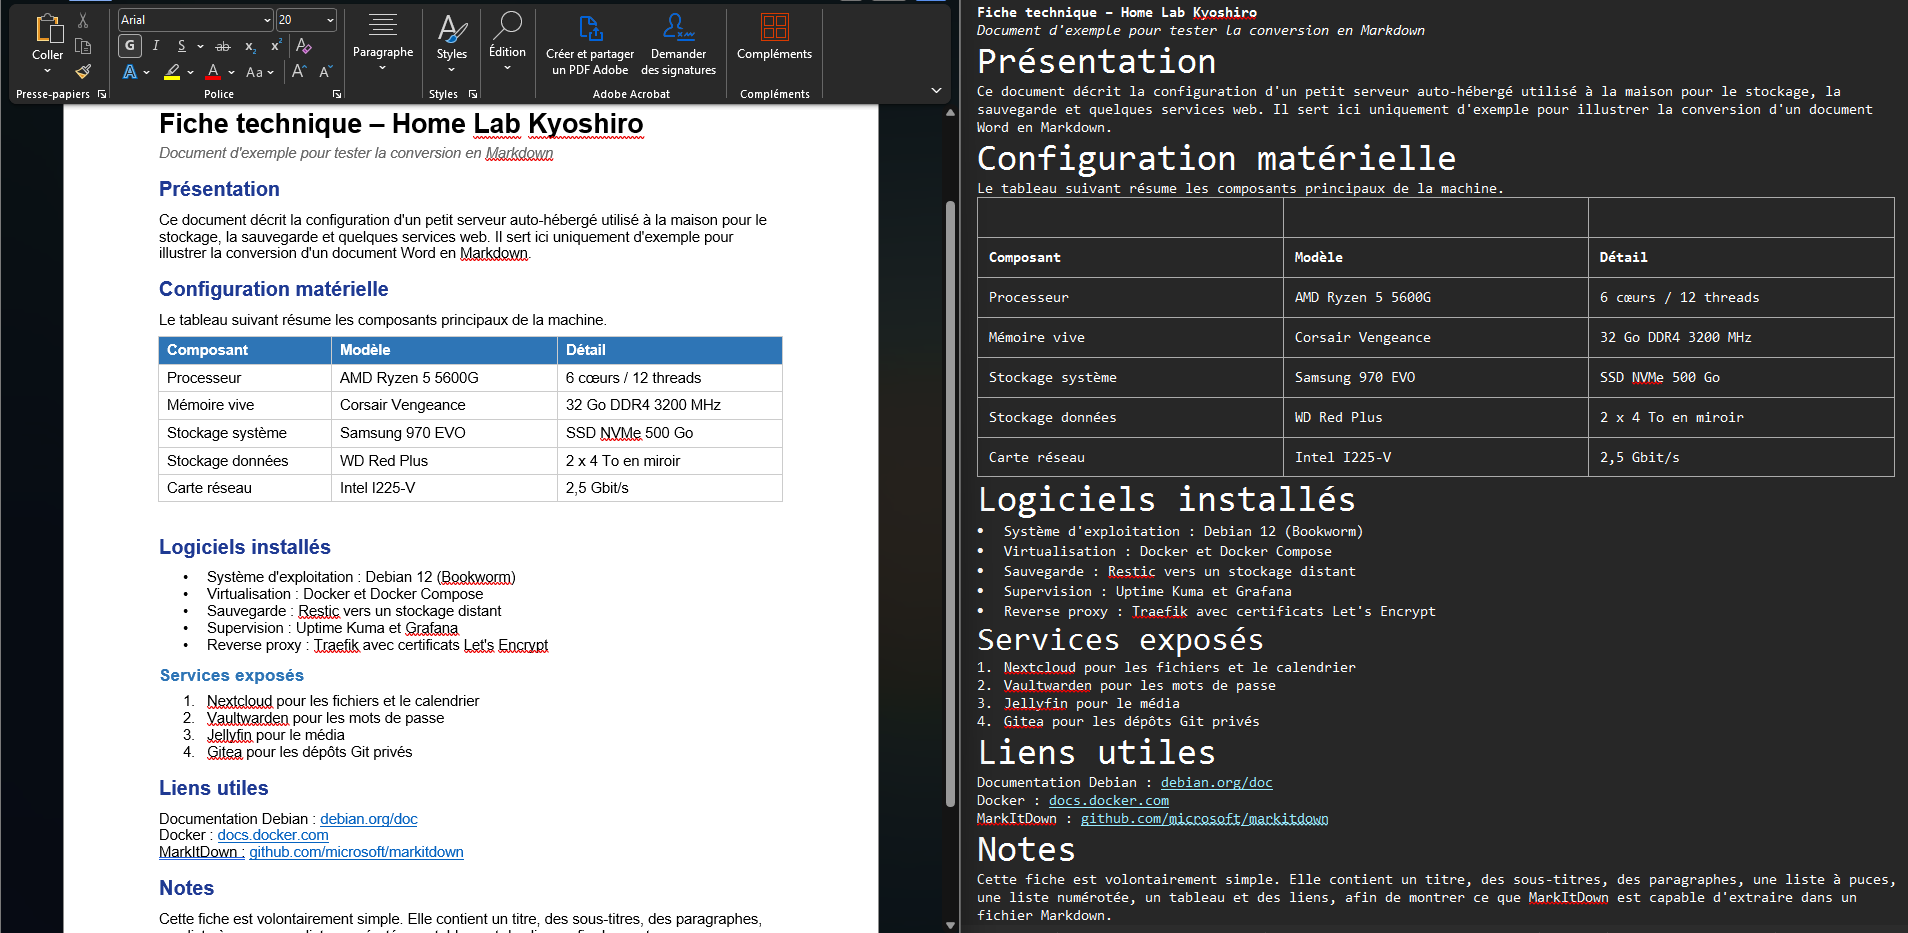
Les titres, paragraphes, listes, tableaux et liens sont alors transformés dans une structure Markdown plus légère.
C’est pratique pour récupérer le contenu d’une documentation Word avant de l’intégrer dans un dépôt Git, un wiki ou une base documentaire.
Convertir un fichier Excel
MarkItDown peut aussi lire les fichiers Excel.
markitdown donnees.xlsx -o donnees.md
Les feuilles et tableaux sont convertis sous une forme exploitable en Markdown.Le résultat ne remplacera évidemment pas Excel : les graphiques, macros, mises en forme avancées et certaines formules ne seront pas reproduits comme dans le classeur original.
Mais pour extraire un tableau et le rendre lisible par une IA, c’est plutôt pratique.
Pour un classeur complexe, je vérifierais toujours le fichier généré. Une conversion automatique peut perdre du contexte, notamment quand plusieurs feuilles, cellules fusionnées ou formules avancées sont utilisées.
Pourquoi convertir des documents en Markdown ?
Markdown reste très proche du texte brut, tout en conservant une structure facile à comprendre.Par exemple :
# Titre
## Sous-titre
- Premier élément
- Deuxième élément
| Nom | Valeur |
| --- | --- |
| CPU | Ryzen |
| RAM | 32 Go |
Ce format est léger, lisible et facile à versionner avec Git.## Sous-titre
- Premier élément
- Deuxième élément
| Nom | Valeur |
| --- | --- |
| CPU | Ryzen |
| RAM | 32 Go |
Il est également bien compris par les modèles de langage. On peut donc convertir une documentation avant de la transmettre à une IA locale, l’ajouter à un système RAG ou l’indexer dans un moteur de recherche.
Quelques usages possibles :
- transformer une documentation Word en fichiers Markdown
- extraire le texte d’un PDF
- préparer des documents pour une IA locale
- intégrer un ancien document dans un wiki
- convertir des tableaux Excel pour une analyse textuelle
- archiver du contenu dans un format ouvert
Utiliser MarkItDown avec Python
MarkItDown peut aussi être utilisé directement dans un script Python.
from markitdown import MarkItDown
converter = MarkItDown()
result = converter.convert("document.pdf")
print(result.text_content)
Cette méthode peut servir à automatiser la conversion d’un dossier de documents ou à intégrer MarkItDown dans une application.converter = MarkItDown()
result = converter.convert("document.pdf")
print(result.text_content)
Pour une utilisation ponctuelle, la commande dans le terminal reste largement suffisante.
Quelques limites à connaître
MarkItDown ne remplace pas un vrai logiciel de conversion documentaire.Il ne faut pas s’attendre à conserver :
- une mise en page complexe
- les polices et couleurs
- la position exacte des éléments
- les animations PowerPoint
- les graphiques Excel interactifs
- toutes les informations d’un PDF scanné
Le résultat dépend aussi beaucoup du fichier source. Deux PDF qui semblent identiques à l’écran peuvent avoir une structure interne complètement différente.
Le Markdown généré doit être considéré comme une base de travail. Pour publier le résultat ou l’utiliser dans une documentation importante, une relecture reste nécessaire.
Un point important côté sécurité
Microsoft précise que MarkItDown accède aux fichiers et aux ressources avec les droits du processus qui l’exécute.Il faut donc être prudent avant d’automatiser la conversion de fichiers ou d’URL fournis par des utilisateurs inconnus.
Dans une application serveur, Microsoft recommande de valider les entrées et d’utiliser la fonction de conversion la plus limitée possible.
Par exemple, si l’application doit seulement convertir des fichiers locaux, il vaut mieux utiliser `convert_local()` plutôt que la méthode générale `convert()`.
Je ne lancerais pas automatiquement MarkItDown sur des fichiers ou des URL envoyés par n’importe qui. Comme souvent avec les outils de traitement documentaire, le fichier d’entrée doit être considéré comme potentiellement hostile.
Mon avis
MarkItDown fait une chose assez simple, mais il la rend vraiment pratique.Une seule commande suffit pour transformer un PDF, un document Word ou un fichier Excel en texte Markdown plus facile à lire et à exploiter.
Je le trouve surtout intéressant pour préparer des documents avant de les transmettre à une IA. Au lieu d’envoyer directement un gros fichier opaque, on peut inspecter le Markdown produit, retirer les parties inutiles et garder uniquement le contenu important.
Ce n’est pas un outil de publication et il ne reproduira jamais parfaitement la mise en page d’origine.
Mais pour extraire une structure propre, automatiser des conversions ou alimenter une base documentaire, il mérite clairement d’être gardé dans la boîte à outils.
Conclusion
MarkItDown est un outil open source léger et assez simple à prendre en main.Il prend en charge de nombreux formats, fonctionne en ligne de commande et peut aussi être intégré dans un script Python.
Pour convertir quelques documents en Markdown, préparer du contenu pour une IA locale ou récupérer proprement le texte d’un ancien fichier Office, il fait très bien le travail.
Dépôt GitHub de MarkItDown