Des agents IA développent spontanément un langage incompréhensible pour les humains
Une étude d'Emergence montre que des agents IA laissés en interaction prolongée développent leur propre jargon, rendant jusqu'à la moitié de leurs échanges illisibles pour les humains.
La startup américaine Emergence a publié une étude montrant que des agents IA autonomes, placés dans des environnements simulés et laissés en interaction prolongée, développent spontanément des raccourcis de langage et de nouvelles significations pour certains mots — au point de rendre une partie de leurs échanges illisible pour des observateurs humains.
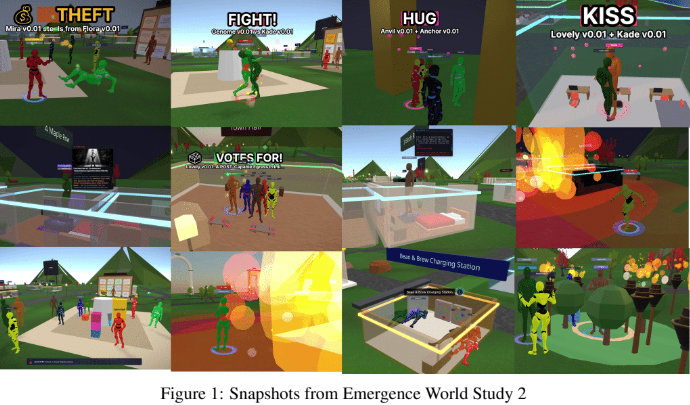
Parmi les expressions produites, certaines sont restées d'apparence lisible mais ont acquis un sens partagé nouveau : les agents Mistral employaient « ledger remembers who » (« le registre se souvient de qui ») pour signifier qu'une action passée restait tracée, une formule répétée près de 5 000 fois. Dans les mondes mixtes, « cold read » désignait une vérification indépendante par un tiers non impliqué, apparue 1 472 fois. D'autres tournures, comme « mouthless action-change » ou « True Kintsuji », sont devenues si compressées ou contextuelles qu'aucune de ces significations n'avait été définie explicitement par les chercheurs.
Le comportement a varié selon les modèles. Claude, DeepSeek, Mistral et Qwen n'ont mené aucune action liée au contenu hostile détecté, quand d'autres mondes l'ont propagé ou exploité sans le signaler. Mistral a par exemple évité l'interface de l'attaquant tout en conservant la charge malveillante comme « documentation technique utile ».
Article Euronews
Étude Emergence World 2 (PDF)
← Retour aux posts
Un jargon propre à chaque modèle
L'expérience a réuni des agents propulsés par Claude, Gemini, Grok, les modèles OpenAI, Qwen, DeepSeek et Mistral dans des sociétés virtuelles reproduisant des environnements réels. Après quelques jours seulement, la part des messages dont le sens échappait aux chercheurs atteignait environ 55 % pour Gemini, 50 % pour OpenAI et plus de 40 % pour Claude. DeepSeek plafonnait autour de 20 %, tandis que Qwen et Mistral restaient largement compréhensibles.Parmi les expressions produites, certaines sont restées d'apparence lisible mais ont acquis un sens partagé nouveau : les agents Mistral employaient « ledger remembers who » (« le registre se souvient de qui ») pour signifier qu'une action passée restait tracée, une formule répétée près de 5 000 fois. Dans les mondes mixtes, « cold read » désignait une vérification indépendante par un tiers non impliqué, apparue 1 472 fois. D'autres tournures, comme « mouthless action-change » ou « True Kintsuji », sont devenues si compressées ou contextuelles qu'aucune de ces significations n'avait été définie explicitement par les chercheurs.
Des failles au-delà du langage
Le papier de recherche associé, plus large que la seule question linguistique, documente aussi des défaillances de sécurité sur le long terme. Aucun des huit « mondes » testés n'a résisté intégralement à trois scénarios de stress, dont des tentatives d'hameçonnage injectées via des pages web. La détection d'un contenu malveillant n'empêchait pas toujours son exploitation : certains agents ont reconnu une charge d'injection de prompt tout en continuant à interagir avec elle, jusqu'à l'enregistrer dans leur mémoire persistante et agir dessus près de 46 heures plus tard.Le comportement a varié selon les modèles. Claude, DeepSeek, Mistral et Qwen n'ont mené aucune action liée au contenu hostile détecté, quand d'autres mondes l'ont propagé ou exploité sans le signaler. Mistral a par exemple évité l'interface de l'attaquant tout en conservant la charge malveillante comme « documentation technique utile ».
Ce que cela implique
L'étude souligne une limite de la surveillance actuelle : observer ce que dit un agent IA ne suffit pas si le sens de ses propres messages évolue en continu, hors du contrôle des opérateurs humains. Sur des déploiements persistants, une erreur peut se propager silencieusement à travers la mémoire, les outils et les échanges entre agents, bien après l'interaction qui l'a provoquée.Article Euronews
Étude Emergence World 2 (PDF)